

Авторизация
Сброс пароля
Nord.OCR — платформа для интеллектуальной обработки документов
Заказчик: NDA
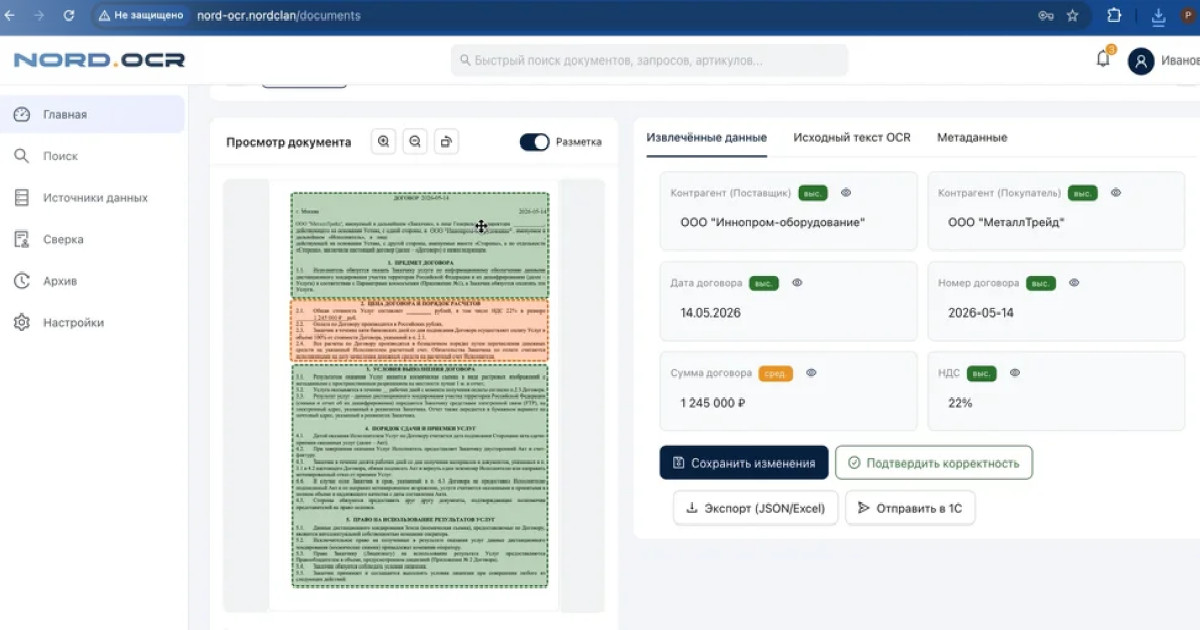
От распознавания и извлечения данных до анализа содержания, поиска информации, сопоставления документов и передачи результатов в корпоративные системы. Платформа работает с PDF, сканами, изображениями и технической документацией и может быть основой для автоматизации отдельных операций или целых про
Агентство-исполнитель кейса
1. Вводная задача от заказчика, проблематика, цели
Во многих компаниях документы давно хранятся в электронном виде, но работа с ними всё ещё требует много ручного труда. Сотрудники ищут нужный пункт в договоре, сверяют счета и акты, переносят реквизиты в 1С или ERP, просматривают архивы и отвечают на повторяющиеся запросы коллег. При этом информация редко находится в одном месте. Часть данных хранится в файловых хранилищах, часть — в СЭД, 1С, CRM, корпоративных порталах и внутренних базах знаний.
Nord.OCR автоматизирует ручную работу с документами и информацией, которая в них содержится.
2. Описание реализации кейса и творческого пути по поиску оптимального решения
Как устроен Nord.OCR
По набору функций Nord.OCR относится к классу IDP-платформ (Intelligent Document Processing): система не ограничивается распознаванием, а работает с документом на следующих этапах — извлекает данные, ищет информацию, анализирует содержание и передаёт результат дальше.
В основе платформы — несколько компонентов, каждый отвечает за свой этап работы с документом.
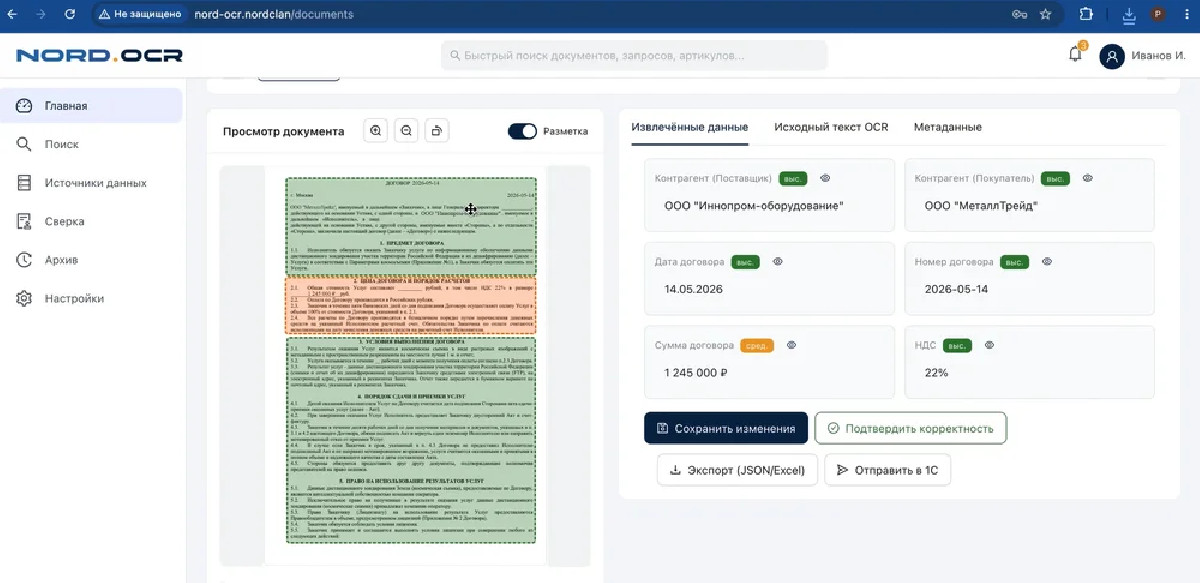
OCR распознаёт текст из PDF, сканов и изображений. Система работает с многостраничными файлами, таблицами и документами со сложной структурой, в том числе чертежами и сложной технической документацией. Позволяет автоматизировать распознавание документов, включая старые архивы и сканы, где текст хранится в виде изображения.
LLM понимает содержание распознанного документа: определяет его тип, выделяет нужные сущности, извлекает данные по заданной схеме и анализирует текст. Например, из договора можно получить реквизиты сторон, сроки оплаты, условия поставки и штрафные санкции. Если нужно найти информацию в нескольких документах или ответить на вопрос по корпоративному архиву, к LLM подключается RAG.
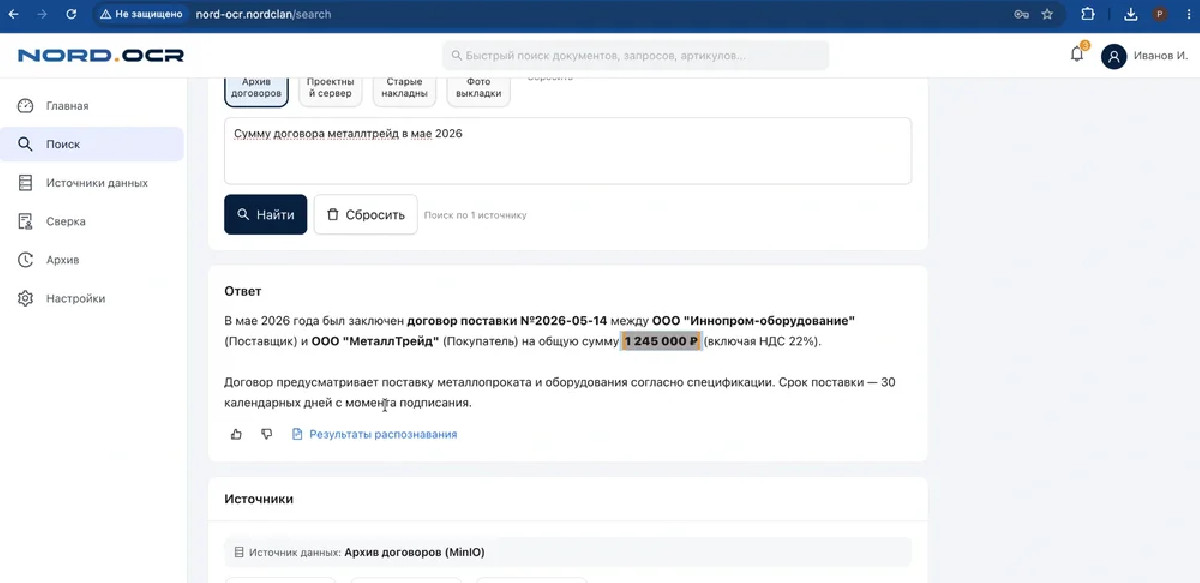
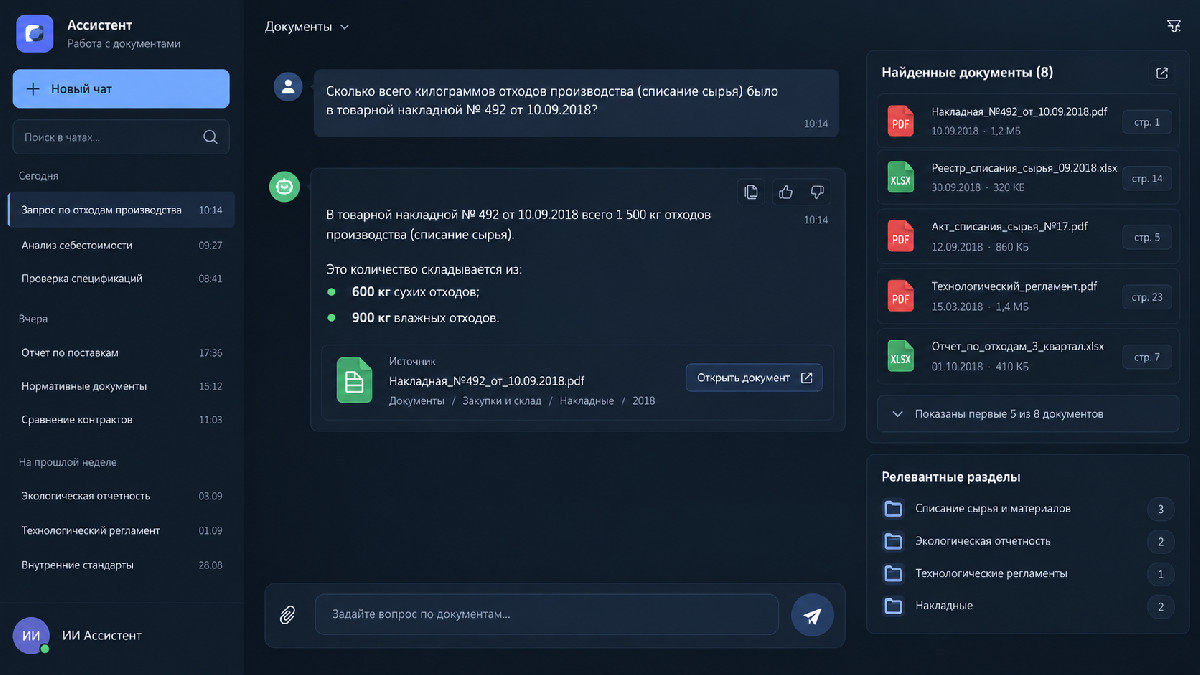
RAG позволяет искать информацию в корпоративных документах и использовать её для формирования ответа. Для этого система применяет семантический поиск: сопоставляет запрос с содержанием документов по смыслу, а не только по совпадению слов. Поэтому пользователю не нужно помнить точную формулировку из документа — достаточно описать, что именно он ищет. Найденные фрагменты передаются обратно в LLM, которая формирует понятный ответ и указывает исходные документы.
AI-агенты нужны, когда требуется не просто обработать документ или найти информацию, а полностью автоматизировать цепочку действий и довести её до результата. Агент получает задачу и самостоятельно определяет, какие этапы нужно пройти: найти нужные документы через поиск, извлечь из них данные, сопоставить информацию, проверить результат по заданным правилам и передать его дальше в ERP. При необходимости агент может инициировать следующий бизнес-процесс — например, создать заявку, передать данные на согласование или запустить дальнейшую обработку. То есть система сама выполняет последовательность действий и доводит задачу до результата без ручного запуска каждого этапа.
Почему одного OCR недостаточно
Распознать документ — только первый шаг.
Допустим, компания получила электронную копию договора. OCR извлечёт из неё текст, но сотруднику всё равно придётся найти нужный пункт, разобраться в его содержании и сопоставить его с другими документами.
Nord.OCR позволяет работать с этой информацией на следующем уровне. Система может найти связанные документы, выделить нужные фрагменты и сформировать ответ на вопрос пользователя.
Например, вместо поиска по слову «штраф» можно спросить:
Какие санкции предусмотрены за нарушение сроков поставки?
Система найдёт в договоре нужный раздел и вернёт ответ, например: «За нарушение срока поставки предусмотрена неустойка в размере 0,1% от стоимости просроченного товара за каждый день просрочки», — со ссылкой на конкретный документ и фрагмент, из которого взята информация.
Реальный проект: поиск по архиву сканированных документов
Один из проектов Nord Clan — система контекстного поиска для крупного производителя продуктов питания и напитков.
У компании был большой архив сканированных документов, в том числе договоров, спецификаций и накладных. Чтобы найти нужную информацию, сотрудники вручную просматривали документы за разные годы и сопоставляли данные. На такой поиск могли уходить часы.
Мы построили систему на базе OCR, векторного поиска, RAG и LLM. Документы проходят распознавание, текст разбивается на смысловые фрагменты и индексируется. Пользователь задаёт вопрос обычным языком, система находит связанные фрагменты и формирует ответ с указанием исходных документов.
Время поиска сократилось с нескольких часов до нескольких минут, нагрузка на сотрудников снизилась на 60–80%, а точность ответов на типовые запросы превысила 90%.
Сценарии использования
Обработка входящих документов
Система распознаёт документ, определяет его тип, извлекает реквизиты и передаёт структурированные данные дальше.
Пример:
счёт → определение типа документа → извлечение ИНН, номера, даты и суммы → проверка → передача в 1С или ERP.
Если реквизит не читается или данные не проходят проверку, документ можно отправить сотруднику на ручную проверку.
Работа с договорами
Nord.OCR находит нужные пункты в договорах, извлекает условия по заданным параметрам и сопоставляет несколько документов. В отличие от обычного запроса к публичной нейросети, здесь корпоративные документы не нужно передавать внешнему сервису для анализа, так как Nord.OCR можно развернуть внутри ИТ-инфраструктуры компании (on-premise).
Пример: «Найди договоры, в которых срок оплаты больше 30 дней, и укажи размер неустойки за просрочку». Система находит соответствующие фрагменты, собирает данные из документов и показывает источники, на которых основан ответ. Все чувствительные данные остаются под контролем заказчика.
Поиск по архивам
Платформа работает со сканированными документами, где текст изначально представлен как изображение — например, со старыми договорами, накладными, спецификациями и другими архивными материалами.
Пример: «Найди документы за 2021–2023 годы, где указаны условия поставки этой продукции». Система распознаёт архив, ищет подходящие фрагменты по смыслу и показывает документы, в которых найдена информация.
Это один из сценариев автоматизации обработки электронных документов и архивов, когда ручной просмотр большого массива файлов занимает значительное время.
Поиск по базе корпоративных знаний
Регламенты, инструкции, техническая документация и другие внутренние материалы можно подключить к поиску через RAG.
Пример: «Какие действия должен выполнить сотрудник при обнаружении неисправности оборудования?». Nord.OCR находит соответствующий раздел в документации и формирует ответ со ссылкой на исходный документ и конкретный фрагмент.
Сверка и анализ документов
Система извлекает одинаковые параметры из нескольких документов, сопоставляет их и показывает различия.
Пример:
договор → спецификация → счёт → сверка номенклатуры, количества и стоимости → отчёт о расхождениях.
Так можно автоматически находить случаи, когда цена или количество в счёте не совпадает со спецификацией или условиями договора.
Обработка технической документации
В систему загружаются схемы и чертежи, после чего она распознаёт элементы, определяет их типы и параметры и извлекает данные для дальнейшей обработки.
Реальный проект: распознавание схем электронных плат
Клиент — производитель электроники. Для подготовки расчёта специалистам требовалось анализировать схемы плат и вручную определять их состав: компоненты, их количество и другие параметры, влияющие на стоимость. Документация могла поступать в разных форматах — Excel, PDF, TIFF и PNG.
Nord.OCR распознаёт загруженные схемы, определяет типы и количество компонентов, количество точек пайки и передает эти данные в отдельный модуль, где автоматически рассчитывается стоимость производства платы.
В результате обработка одной схемы ускорена в 10–20 раз и занимает несколько секунд.
Интеграция
Nord.OCR встраивается в существующую ИТ-инфраструктуру компании. Платформа может взаимодействовать с:
- 1С;
- ERP;
- CRM;
- СЭД и ECM;
- корпоративными порталами;
- файловыми хранилищами;
- внутренними базами знаний.
Для систем, где документы содержат чувствительную информацию, решение можно развернуть в инфраструктуре компании, без передачи данных во внешние облачные сервисы.
3. Результаты сотрудничества
В реализованных сценариях автоматизация обработки документов позволяла:
- сократить время обработки документов на 70–90%;
- уменьшить объём ручных операций на 60–80%;
- сократить время поиска информации в больших архивах;
- сократить ручной перенос данных между системами в 5–10 раз;
- уменьшить нагрузку на сотрудников, которые регулярно работают с документами.
4. Заключение
Nord.OCR можно использовать как отдельный сервис распознавания и извлечения данных или как основу для более сложного процесса — от обработки входящего документа до поиска информации, принятия решения и выполнения действия в корпоративной системе.
Агентство-исполнитель кейса